So sánh hiệu suất
So sánh TrueForge với Claude Managed Agents và deepagents về cùng các tác vụ, công cụ và mô hình – và cách tái hiện sự khác biệt này.
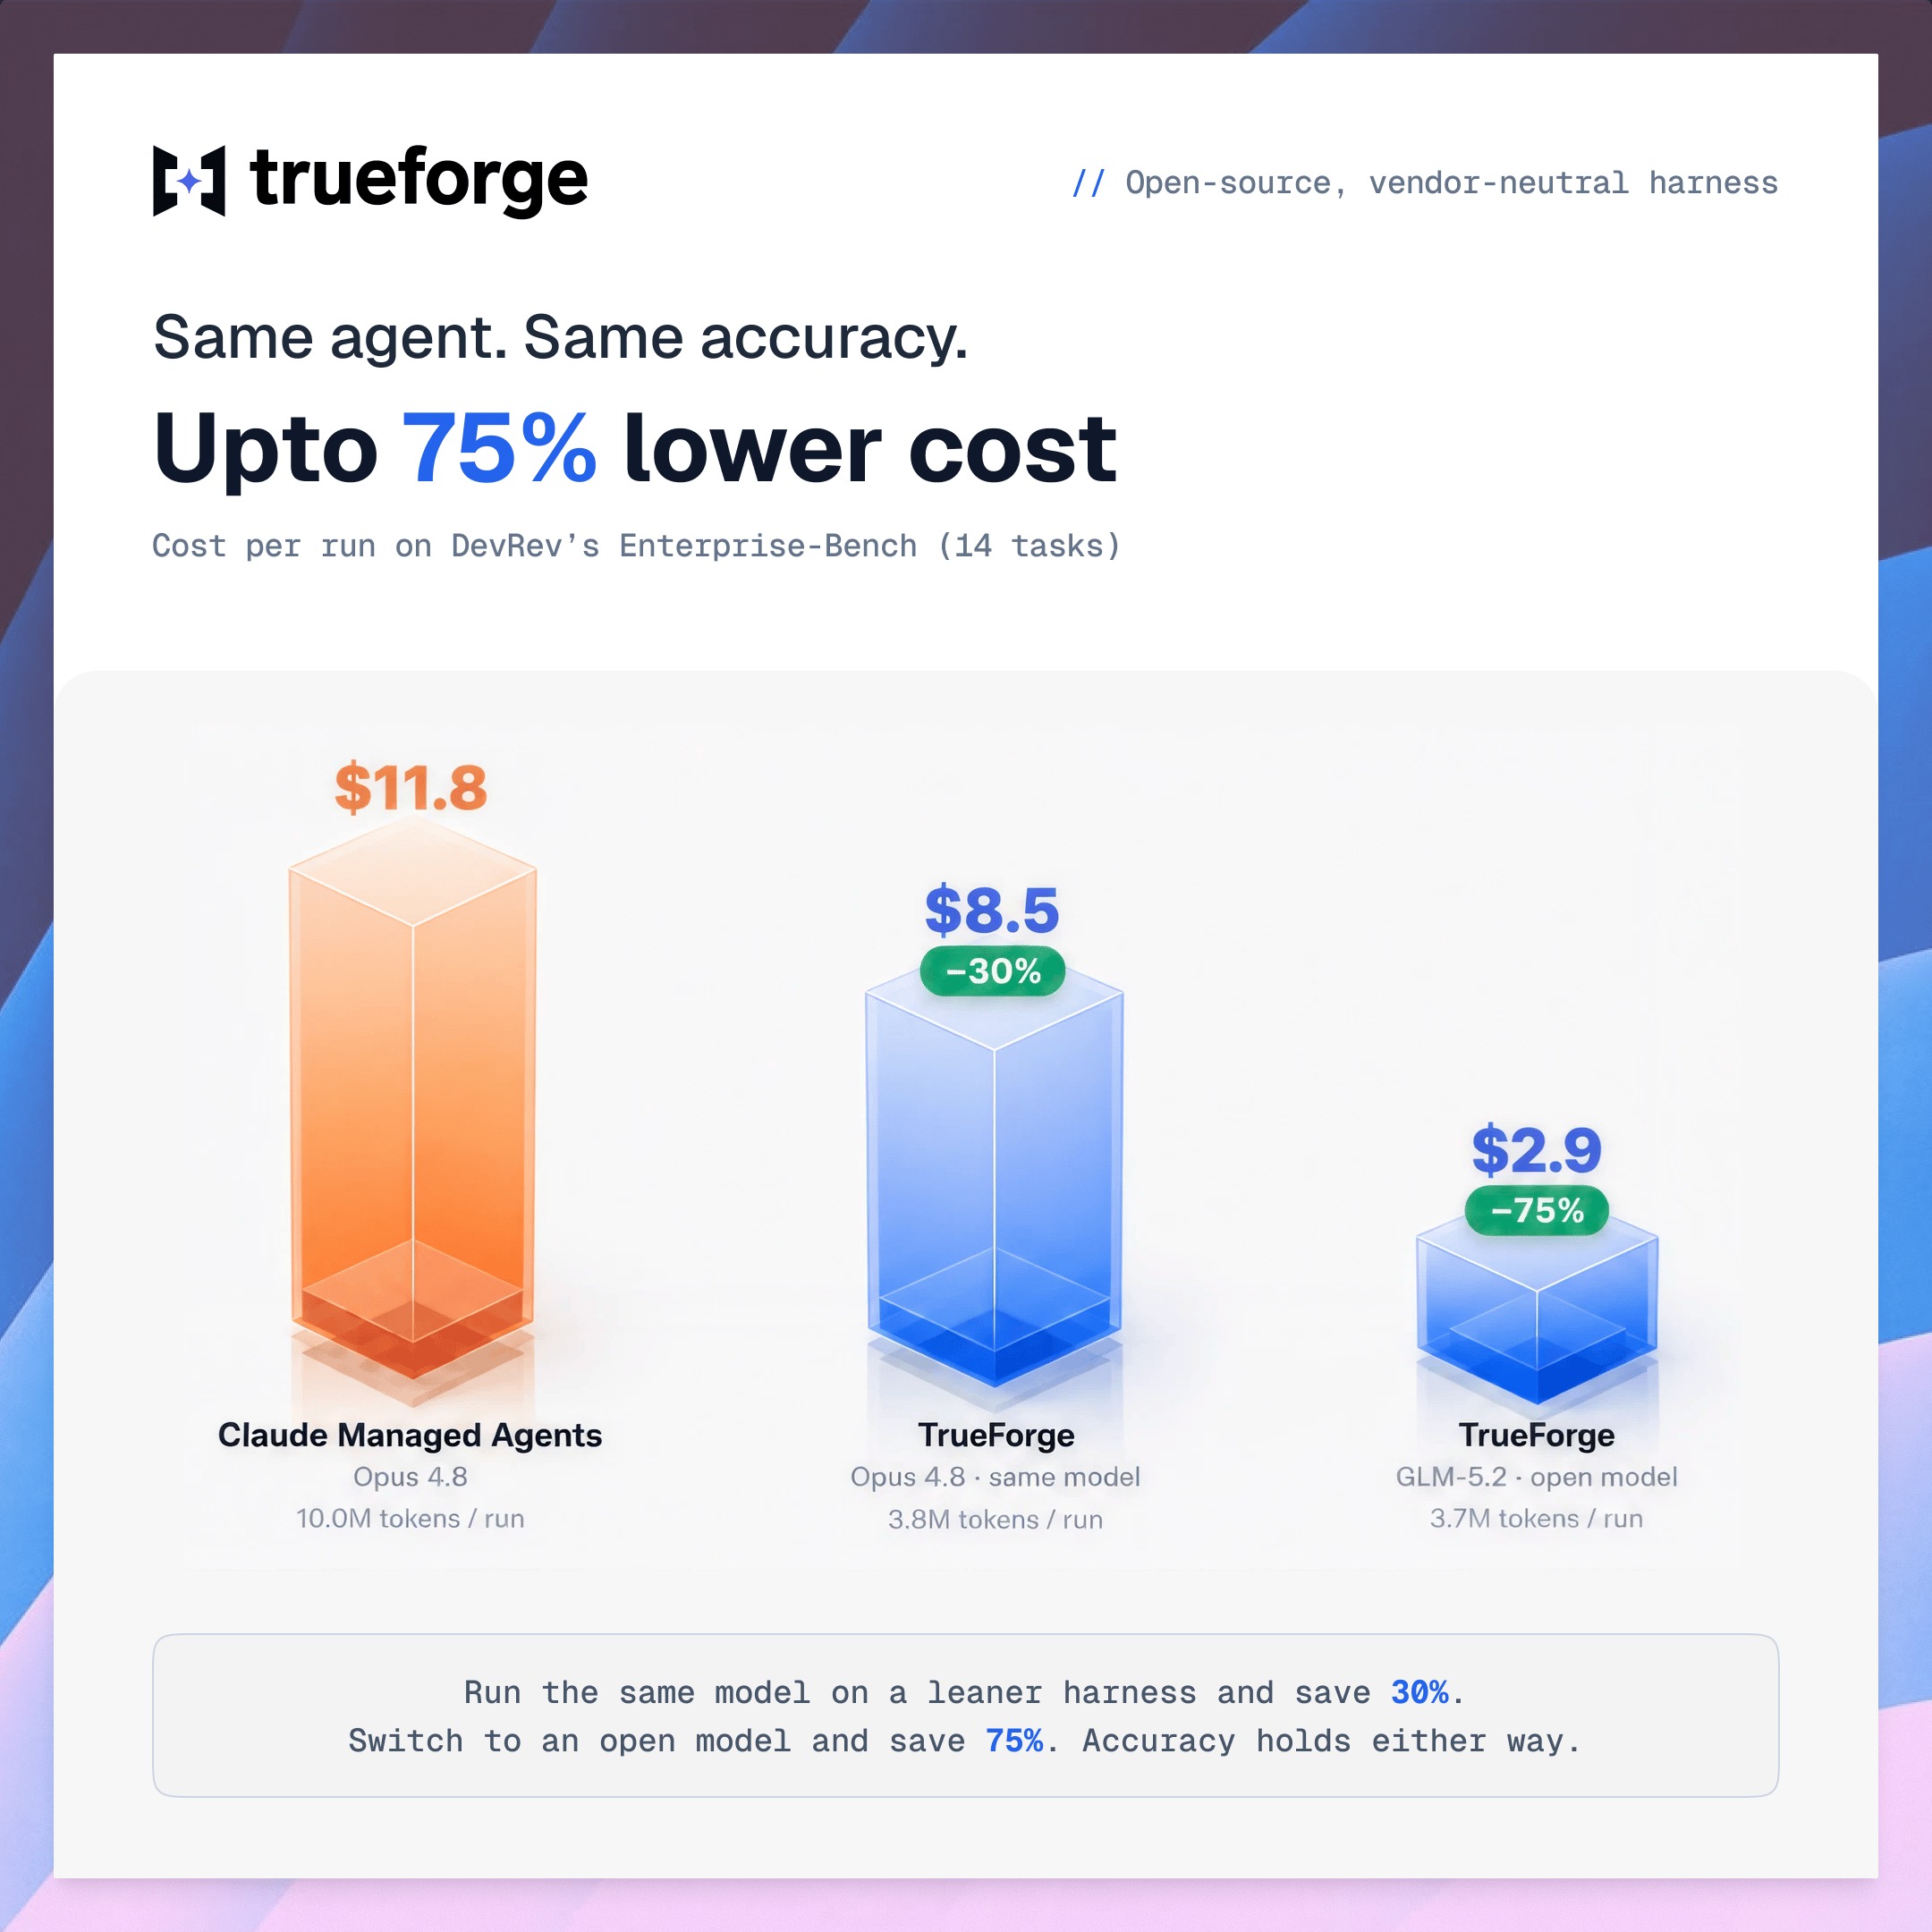
- Rẻ hơn khoảng 30% so với dịch vụ quản lý đại lý của Claude trên cùng một mô hình (Opus 4.8).
- Rẻ hơn khoảng 2,5 lần so với DeepAgents trên cùng một mô hình.
- Chi phí vận hành thấp hơn khoảng 75% khi sử dụng mô hình mã nguồn mở hiệu quả GLM-5.2 , mà chất lượng vẫn tương đương.
Những gì chúng tôi đã đo lường
Chúng tôi sử dụng các tác vụ L1-L2 từ Enterprise-Bench của DevRev – 14 tác vụ liên hệ giữa các hệ thống, mô phỏng công việc vận hành B2B thực tế trên các bộ phận kỹ thuật, bán hàng và hỗ trợ. Mỗi tác vụ yêu cầu nhân viên kết nối dữ liệu trên ba máy chủ MCP: một hệ thống CRM (kiểu Salesforce), một hệ thống theo dõi dự án (kiểu Jira) và một kho lưu trữ tài liệu (kiểu Drive).
Cách chúng tôi đo lường
Mỗi bộ khung kiểm thử đều chạy cùng một mô hình, cùng ba máy chủ MCP và cùng một dấu nhắc hệ thống, với mỗi tác vụ được thực hiện trong một phiên mới và không có gì được chuyển tiếp từ phiên trước. Chúng tôi thực hiện n = 3 lần thử nghiệm cho mỗi cấu hình và báo cáo giá trị trung bình.Các câu trả lời được chấm điểm bởi một giám khảo LLM độc lập, người chỉ xem xét các tiêu chí của bài tập và câu trả lời – chứ không bao giờ biết được bộ dây dẫn nào đã tạo ra câu trả lời đó – và một bài tập chỉ được coi là đạt nếu đáp ứng mọi tiêu chí yêu cầu.
Kết quả
Solved / 14là số lượng nhiệm vụ trung bình được hoàn thành trong mỗi lần thử (n = 3 lần thử cho mỗi cấu hình).
Theo nhiệm vụ
Các nhiệm vụ được hoàn thành qua 3 lần thử nghiệm, theo từng cấu hình:
Vì sao nó rẻ hơn?
Phần lớn chi phí trong một lần chạy tác nhân nằm ở vòng lặp, chứ không phải câu trả lời cuối cùng – mỗi lần công cụ thực hiện đều gửi ngữ cảnh ngày càng tăng trở lại mô hình. TrueForge giữ cho vòng lặp đó gọn nhẹ:
- Ngữ cảnh được đơn giản hóa trong mỗi lượt. Nó hoạt động dựa trên hướng dẫn ngắn gọn thay vì cấu trúc phức tạp; deepagents cũng tích hợp lập kế hoạch, hệ thống tập tin ảo và cơ chế tác nhân phụ trong mỗi lượt.
- Số lần gọi công cụ ít hơn. Nó lên kế hoạch thực hiện ít lần gọi công cụ nhất trong ba công cụ để đạt được kết quả tương tự – 19 lần gọi cho mỗi tác vụ, so với 32 và 40 lần gọi của các công cụ khác.
- Phương pháp này nén dữ liệu thay vì phát lại. Nó cắt bớt lịch sử và giảm tải các phản hồi lớn từ công cụ thay vì gửi lại mọi thứ nguyên văn; deepagents đọc lại ngữ cảnh đã tích lũy từng bước một, đó là lý do tại sao nó cần số lượng token gấp ba đến bốn lần cho cùng một tác vụ.